איך לגרום לסוכנים של ה-AI לקרוא את האתר שלכם כמו שצריך? Agent Readiness Check
קידום אתרים » בלוג » איך לגרום לסוכנים של ה-AI לקרוא את האתר שלכם כמו שצריך? Agent Readiness Check
אחד הנושאים המדוברים ביותר בכל מה שקשור לגישה של מנועי AI לאתרי אינטרנט הוא האופן בו אנחנו מאפשרים להם לקרוא את האתר שלנו:
האם אנחנו בכלל רוצים לתת להם גישה לאתר? ואם כן, האם רק עבור מתן תשובות לגולשים, או גם עבור אימון. לכאורה אם דואגים לתת את ההנחיות המתאימות בקובץ robots.txt ודואגים לקוד HTML שלא מוסתר מאחורי סקריפטים, הכול בסדר, לא?
ובכן, מסתבר שהנושא עצמו הרבה יותר מורכב, וכדאי להסביר קודם כל למה פתאום אנחנו מדברים על "סוכני AI" ולא רק על GEO או מנועי תשובות:
המונח "סוכן AI" מתייחס למערכת שיכולה לפעול עבור המשתמש ולא רק לספק לו תשובה. סוכן כזה מסוגל לגלוש באתרי אינטרנט, לקרוא מידע, לזהות שירותים שונים, להתחבר לכלים שכוללים ממשק מתאים ואף לבצע פעולות. לכן מוכנות לסוכני AI היא לא רק אופטימיזציה למנועי תשובות או לזחלני AI: היא בודקת לא רק אם המערכת יכולה למצוא ולהבין את התוכן, אלא גם אם היא יכולה להשתמש באתרי אינטרנט בצורה מסודרת ובטוחה.
אז עד כמה אתרי אינטרנט באמת מוכנים לסוכני ה-AI. זה בדיוק מה שהסקר של Cloudflare מאמצע חודש אפריל 26 בדק. ומכיוון ש-Cloudflare מארחת את רשת ה-CDN הגדולה ביותר כיום, לא מדובר בסתם בדיקה שנועדה לעשות כותרות.
סיכום - אמ;לק (ארוך מדי, לא קראתי)
• על פי הסקר, מרבית האתרים המובילים בעולם כבר מטמיעים את ההגדרות החשובות ביותר שהן הנחיות בקובץ Robots.txt ומפת אתר
• לא כל הבדיקות בדו"ח של Cloudflare חשובות באותה מידה ועבור רוב האתרים שלוש הקטגוריות הראשיות (גילוי, תוכן וגישה לבוטים) הן הקריטיות כרגע.
• Link Headers הם סוג של קישורים מהירים עבור כלים שה-AI משתמש בהם
• קבצי MD ו-DNS for AI DISCOVERY יכולים לעזור לסוכנים לקרוא דפי HTML ולאתר שירותים על הדומיין אליהם הם יכולים להתחבר, כמו למשל API למתכנתים.
• בדיקת ה-BOT Access Control יכולה להיות שימושית עבור מי שלא רוצה לתת אפשרות לסוכנים להשתמש בתוכן שלו למודל האימון, אך יש לכך גם סיכון בהורדת החשיפה בתשובות AI.
• בדיקת הקומרס חשובה לאתרים שרוצים לאפשר בעתיד רכישה באמצעות סוכנים, אך ייתכן שאם אתם לא משתמשים במערכת e-commere ידועה, תצטרכו להטמיע את התקנים על פי התיעוד אחד אחד כדי שתוכלו לבצע אותה מלכתחילה.
• הבדיקות של Cloudflare לא מחליפות ביצוע של אופטימיזציה מותאמת למנועי חיפוש מבוססי AI מכיוון שהן לא עוסקות כמעט במהות התוכן שבאתר.
אז מה גילה הסקר של Cloudflare?
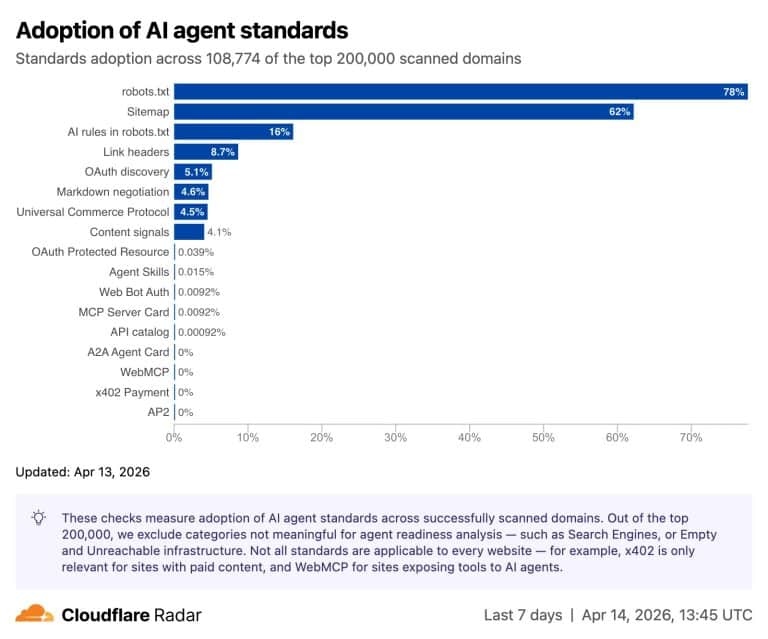
הסקר לקח 200,000 דומיינים מובילים ובדק אילו התאמות מבצעים 108,774 הדומיניים המובילים.
באופן לא מפתיע, ברוב האתרים יש כבר קובץ robots.txt ומפות אתר, אבל אלו לא בהכרח מתייחסים לסוכני AI. ההתייחסות להוראות עבור סוכני AI נמצאת רק אצל 16% מהאתרים (אם משאירים את ברירת המחדל לכל הזחלנים, אז למעשה מרשים גם לזחלנים של סוכני AI להיכנס).
בהמשך אפשר לראות עוד כמה פרמטרים שנוגעים באספקטים קצת פחות מוכרים, ומהשורה התשיעית (0auth Protocol Structure) יש כבר רשימה די ארוכה של סטנדרטים שכמעט שום אתר לא מיישם. לכן, גם אם אתם מעולם לא שמעתם עליהם, אתם בחברה טובה. אבל חשוב להבין מה הם באמת אומרים ועד כמה הם קריטיים, ובשביל זה בדיוק אנחנו כאן.
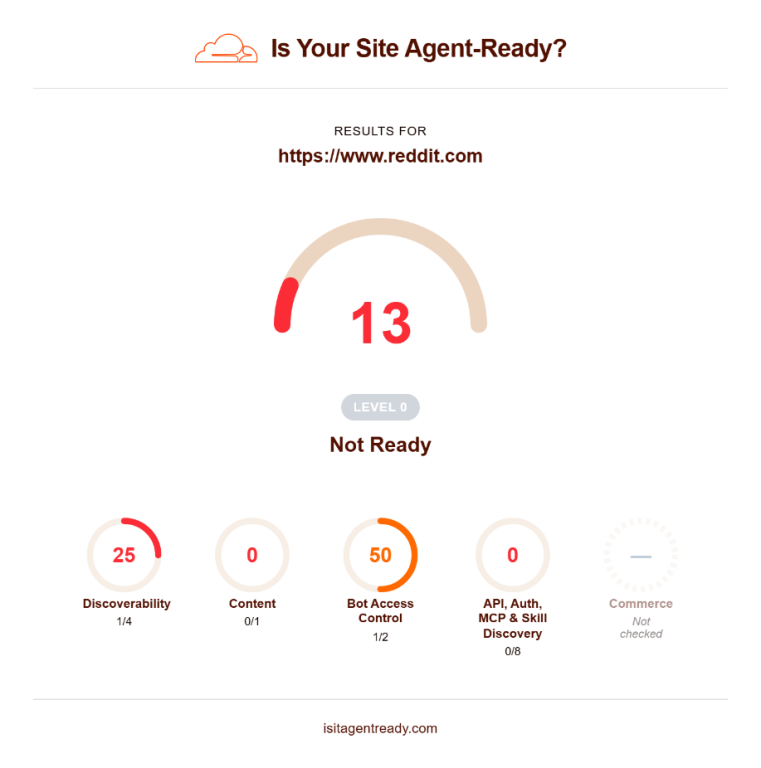
מבט מהיר בדו"ח
כשמריצים דו"ח פרטני על אתר אינטרנט מקבלים חמש בדיקות שונות שניתן לשנות באופן ידני על פי סוג האתר.
בהתאם למה שכבר ראינו בסקר, לא מפתיע שאפילו אתרים שמנועי AI אוהבים "לזלול" כמו Reddit עדיין מקבלים ציונים די נמוכים.
בכל אופן, שלושת הבדיקות הראשונות משמאל הן הבדיקות הכי מהותיות, הבדיקה הבאה פחות קריטית ואלו הבדיקה האחרונה היא ספציפית לאתרי אי-קומרס.
מהבדיקה שלנו גם באתרים שיש בהם מערכת אי-קומרס היא לא תמיד מתבצעת. זה עלול לקרות במיוחד אם האתר משתמש במערכת מותאמת אישית ולא נשען על פלטפורמה מוכרת כמו Shopify או WooCommerce.
בגוף הדו"ח אפשר למצוא הסבר על כל אספקט וקישור לתיעוד והסברים או אפילו Skills (אותם ניתן לתת נניח לקלוד קוד). ההסברים הם די טכניים, אם כי מנהל האתר שלכם אמור להיות מסוגל להבין איך להטמיע אותם.
אנחנו נתמקד בהסברים כללים ומה בעצם אומר כל אספקט כדי שתוכלו להבין את הדו"ח ביתר קלות ויותר חשוב, במה באמת צריך להתעמק ועל מה לא שווה לשבור את הראש.
Discoverability (גילוי)
זו הבדיקה הכי חשובה מכיוון שהיא מראה האם האתר בכלל זמין לסוכני AI. בהנחה שיש לכם קובץ Robots.txt וקובץ מפת אתר תקינים, כנראה תעברו את שני הסעיפים הראשונים, מה שמשאיר אותנו עם Link Headers ו-DNS for AI Discovery
Link headers
קישור רגיל שמנועי חיפוש כמו גוגל קוראים מופיע בתוך העמוד ולכן סוכן AI חייב קודם לסרוק ולנתח את הדף כדי למצוא אותו. לעומת זאת, קישור מסוג Link Header נשלח כבר בזמן הפנייה הראשונית אל השרת ולכן יותר קל למצוא אותו.
כך פחות או יותר נראה המבנה:
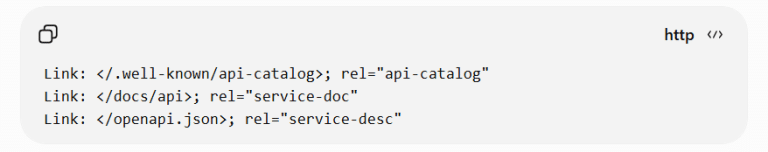
אם להודות על האמת, בחלק גדול מהאתרים הם לא באמת נחוצים, והם רלוונטיים בעיקר באתרים שיש בהם כלים או הסברים על מה שה-AI יכול לגשת אליו (לדוגמה, התממשקות מול כלי מסוים).
אם זה אכן המצב, אפשר להטמיע אותם דרך תוספים שונים או הגדרות ספציפיות של ה-Headers, כמו במקרה של אתרים שיושבים על הרשת של Cloudflare.
DNS for AI Discovery
DNS AID אולי נשמע כמו שם מפחיד, אבל הוא הרבה יותר פשוט מכפי שהוא נשמע: מדובר במנגנון מוצע לפרסום סוכני בינה מלאכותית ושירותים כמו שרתי MCP באמצעות פרוטוקול ה-DNS הסטנדרטי ברשת.
פרוטוקול ה־DNS מתרגם כתובות ברשת ("דומיינים") לכתובות השרת המתאימות על פי מספר ה-I.P. כדי שלא נצטרך להקליד סדרה של מספרים בכל פעם שאנחנו רוצים להיכנס לאתר מסוים.
MCP הוא תקן שמאפשר לסוכני בינה מלאכותית להתחבר בצורה מסודרת לכלים ולמקורות מידע חיצוניים.
בסופו של דבר "DNS AID" מאפשר לסוכנים לגלות אילו סוכנים ושירותים אחרים פועלים תחת הדומיין, מהן היכולות שלהם וכיצד ניתן להתחבר אליהם. הוא אינו מאיץ את קריאת האתר ואינו משפר את הנראות של מאמרים בתשובות של מערכות בינה מלאכותית.
לכן אתר תוכן או אתר עסקי רגיל, שאינו מציע שירות שסוכנים יכולים להפעיל, בדרך כלל אינו זקוק לו.
בכל אופן, את הרשומות מגדירים אצל הספק שמנהל את ה־DNS של הדומיין. זה יכול להיות רשם הדומיין, חברת האחסון או שירות חיצוני. נכון לאוגוסט 2026, המנגנון עדיין נמצא בשלב של טיוטת תקן, ולכן הבדיקה של CloudFlare היא מעט מטעה מבחינת הציון שהיא נותנת.
תוכן (Markdown)
זהו סגמנט חשוב במיוחד, אבל הבדיקה של CloudFlare לא עוסקת בהכרח באופן בו התוכן הרגיל של האתר פרוס מבחינת מבנה פסקאות, משפטים וכל מה שאנחנו מדברים עליו תחת המטריה של אופטימיזציה למנועי חיפוש גנרטיביים, אלא ב-Markdown.
Markdown (MD) הוא פורמט טקסט פשוט שמציג את המבנה של דף אינטרנט בלי רוב הקוד שאחראי לעיצוב ולתפעול שלו. גרסת MD היא לא רק טקסט רציף או גרסת הדפסה, אלא שומרת על כותרות, פסקאות, רשימות, טבלאות, קישורים, תמונות והדגשות, תוך כדי השמטה של תפריטים, באנרים, כפתורים, עיצוב וסקריפטים שאינם נחוצים להבנת התוכן.
לדוגמה, ככה נקרא קובץ MD שמייצג עמוד HTML מקביל עם כותרת פשוטה וטקסט מתחת:
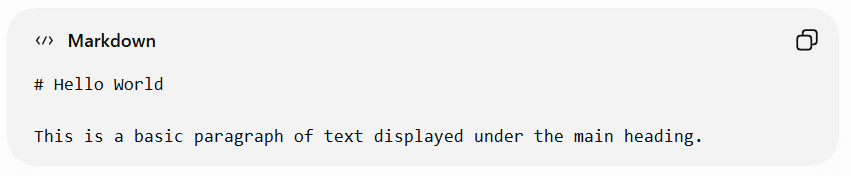
אין חובה ליצור קובץ MD לכל עמוד. באמצעות מנגנון של התאמת תוכן, אותה כתובת יכולה להחזיר דף HTML רגיל לדפדפן וגרסת MD לסוכן שמבקש אותה. הסוכן מציין בבקשה שהוא מעדיף לקבל MD, והשרת ממיר את העמוד או מחזיר גרסה שהוכנה מראש.
כך אפשר להימנע מכפילויות או צורך להשתמש בהבהרות קנוניקל.
גם כאן הבדיקה של Cloudflare יותר דרמטית מכפי שהנושא באמת: סוכני בינה מלאכותית מסוגלים לקרוא דפי HTML תקינים, אם כי MD עשוי להקל עליהם לזהות את המבנה והתוכן המרכזי בלי לעבד קוד מיותר.
לכן, אם אתם יכולים להטמיע מנגנון MD באמצעות שילוב תוסף או הטמעת קוד, עשו זאת, אבל זה ממש לא אסון אם כרגע אין לכם את היכולת הזו.
Bot Access Control
הסגמנט הזה עוסק בכל מה שקשור למתן גישה והרשאות לבוטים של סוכני AI לאתר שלכם.
AI bot rules in robots.txt
הבדיקה הזו בודקת את ההוראות שלכם לסוכני AI. אם כבר עברתם את הבדיקה של קובץ robots.txt תקין, תעברו את זו אוטומטית, גם אם יש לכם הוראות כלליות בלבד שחלות גם על סוכני AI.
מה שהבדיקה הזו בודקת בפועל היא הוראה לסוכנים הספציפיים שאחראים לדברים כמו אימון או חיפוש ברשת בזמן מתן תשובה. לכל חברה יש סוכנים אחרים ומדובר ברשימה די ארוכה.
לדוגמה, ל־OpenAI יש שלושה בוטים נפרדים:
- GPTBot – סורק תוכן שעשוי לשמש לאימון ולשיפור המודלים.
- OAI-SearchBot – מוסיף תוכן לאינדקס שמשרת את החיפוש של ChatGPT.
- ChatGPT-User – מבקר בעמוד בזמן אמת בעקבות בקשה של משתמש, למשל כאשר מבקשים מ־ChatGPT לקרוא קישור מסוים.
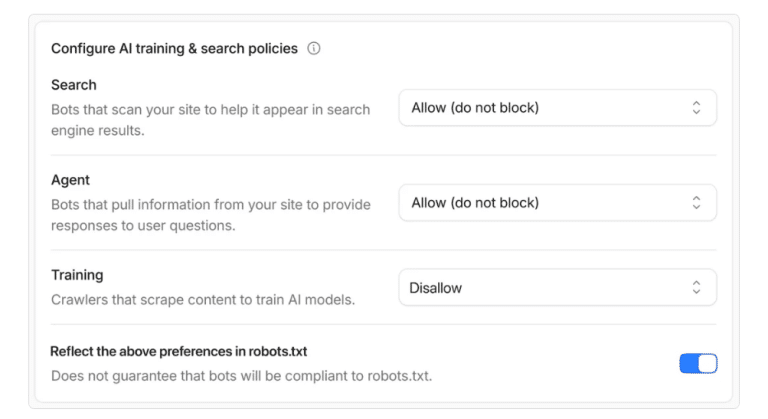
עבור רוב האתרים, ההחלטה הכי קריטית כאן היא לבחור האם לתת למודלים השונים גישה לאימון על התוכן שלכם.
מצד אחד גישה כזו יכולה "לגנוב" לכם תוכן. מצד שני, אסור לשכוח שהאימון אחראי לעיבוד מידע שהמודל יכול להתייחס אליו אם הוא לא ניגש לרשת, והתלות של סוכנים בחיפוש ברשת משתנה בין סוכן לסוכן. אם מודל לא עבר על המידע שלכם והוא לא שולף מידע מהרשת, הוא פשוט לא יציין אתכם בתשובה גם אם אתם רלוונטיים.
לכן לא היינו ממהרים לחסום את הבוטים של החברות השונות, אלא רק נתיבים ספציפיים שיכולים להיות רגישים במיוחד ואתם לא חוסמים אותם באופן גורף מבוטים אחרים.
ההוראות והתיעוד שונות עבור כל סוכן AI. לכן כדאי לבדוק את המידע הרשמי מהאתרים של OpenAI, Google, Anthropic וכו'.
שימו לב: בחלק מהשירותים, יש הגדרות שעלולות לעקוף את Robots.txt, אם כי ב-Cloudflare עצמה קיימת אפשרות חדשה לסנכרן בין הקובץ לבין מסך ההגדרות.
Web Bot Auth
Web Bot Auth היא בדיקה שאומנם נכנסת בתוך ברירת המחדל, אבל היא מיועדת בעיקר לאתרים שמפעילים בוטים בעצמם ולכן כנראה שהיא לא תהיה רלוונטית אליכם.
Content Signals in robots.txt
זהו חלק שמתייחס לאפשרויות שונות בתוך קובץ robots.txt שעוזרות לקבוע תפקידים שונים גם עבור בוטים שלא מבצעים פעולות ספציפיות כמו איסוף מידע לשם אימון. חלק מאלו הן אפשרויות לא סטנדרטיות ולכן לא תהיה להן משמעות עבור בוטים סטנדרטים כמו למשל Google Bot.
כך זה עשוי להיראות:
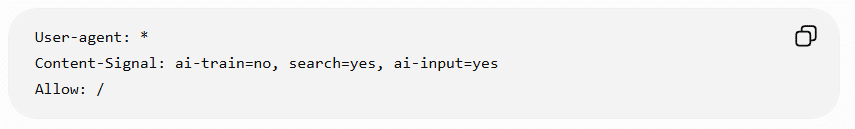
• AI-Train – הוראה ספציפית – האם המודל יוכל להתאמן על המידע באתר
• Search – האם המודל יוכל לגשת אל האתר כאשר הוא מחפש ברשת
• AI-input האם ניתן להפוך מידע שמקורו בחיפוש ברשת למידע שיאמן את המודל.
יש לשים לב שההוראות האלו ניתנות ברמת ה-User-Agent, ולכן גם השורה Allow: / לא קשורה להוראות הספציפיות של Content-Signal.
הבעיה היא שבוטים כללים לא בהכרח חייבים לכבד את ההוראות האלו, מה שהופך גם את הבדיקה הזו למעט מטעה.
API, Auth, MCP & Skill Discovery
החלק הזה בדו"ח הוא מעט טכני ועוסק בחיבורים של הסוכנים לשירותים שונים באתר. אם אתם עוסקים ב-Vibe Coding דרך קלוד או Codex, ייתכן שתכירו חלק מהם.
הנה ההסבר הכי פחות טכני שיכולנו לתת למי שרוצה להעשיר את הידע:
• OAuth ו־ OpenID Connect – מסבירים לסוכן כיצד להתחבר לשירות בצורה מאובטחת ולקבל הרשאה לפעול בשם המשתמש, בלי לקבל ממנו את הסיסמה.
• OAuth Protected Resource – מציין אילו אזורים או שירותים באתר מוגנים, לאיזו מערכת התחברות צריך לפנות ואילו הרשאות דרושות כדי להשתמש בהם.
• WebMCP – מאפשר לאתר להציג פעולות מוגדרות שסוכן יכול לבצע ישירות. למשל חיפוש מוצר, הוספה לסל או בדיקת סטטוס הזמנה, במקום שהסוכן ינסה ללחוץ על כפתורים כמו משתמש אנושי.
• API Catalog – משמש כקטלוג של ממשקי התוכנה והשירותים שהאתר מציע. הוא עוזר לסוכן לגלות מה ניתן לבצע והיכן נמצא כל שירות.
• Auth.md – קובץ הסבר שמלמד סוכן כיצד להירשם לשירות, אילו הרשאות הוא יכול לבקש וכיצד הוא מקבל פרטי גישה. זהו מנגנון חדש יחסית ולא תקן שחייבים ליישם.
• MCP Server Card – כרטיס מידע המתאר שרת MCP, הכלים שהוא מציע והדרך להתחבר אליו. MCP הוא תקן שמאפשר לסוכנים להשתמש בכלים ובמקורות מידע חיצוניים.
• A2A Agent Card – כרטיס שמתאר סוכן AI שהאתר מפעיל, את היכולות שלו ואת הדרך שבה סוכנים אחרים יכולים לתקשר איתו.
• Agent Skills Index – רשימה מסודרת של מיומנויות או משימות שסוכן יכול לבצע באמצעות האתר, יחד עם הוראות השימוש בהן.
• ARD – מעין קטלוג רחב שמרכז במקום אחד את הסוכנים, הכלים, המיומנויות וממשקי התוכנה שהאתר מפרסם, כדי שמערכות חיצוניות יוכלו לגלות אותם.
Commerce
אלו בדיקות שמיועדות לפרוטקולים חדשים שמאפשרים לסוכני AI לבצע איסוף אוטומטי של מוצרים בחנויות וירטואליות ואפילו לשלם במקרים מסוימים מבלי לעבור באופן ידני בכל החנות.
יש כאן כמה תקנים נפרדים ויוזמות של חברות שונות:
Universal Commerce Protocol או UCP
תקן שפותח על ידי Google ו־Shopify ומכסה את מסע הקנייה, מחיפוש מוצרים ועד תשלום וטיפול בהזמנה. המטרה היא לאפשר קנייה דרך Gemini ומצב ה־AI של Google. חנויות Shopify עשויות לקבל תמיכה דרך הפלטפורמה בלי לפתח את החיבור בעצמן. לכן אם יש חנות בפלטפורמה, הבדיקה הזו לא אמורה להדאיג אתכם.
Agentic Commerce Protocol או ACP
תקן של OpenAI ו־Stripe שמאפשר לסוכן להעביר מידע על מוצרים, סל והזמנה בין ChatGPT לבין החנות. הוא רלוונטי בעיקר לעסקים שרוצים לשלב את אפשרויות הרכישה של Stripe.
למרבה הצער, גם רכישות באמצעות ChatGPT וגם קבלת תשלום דרך Stripe עדיין לא זמינים בישראל, ומסיבה זו הבדיקה הזו רלוונטית בעיקר למי שמנהל אתר בחו"ל.
X402
אחת הבעיות שהשימוש ב-AI גרם להן בתחום התוכן היא העובדה שהסוכנים "שואבים" מידע מאתרים והופכים אותם עצמם ללא רלוונטיים מכיוון שהגולש לא צריך להיכנס אליהם כדי לקבל את המידע שהוא צריך. עבור אתרים שמתבססים על מודעות, מדובר בסכנה ממשית למודל העסקי שלהם.
אחד הפתרונות הוא הצבת חומת תשלום בפני סוכן ה-AI. אם הסוכן רוצה לקבל את המידע, הוא צריך לשלם.
המספר 402 מציין סטטוס שרת שאומר "התוכן הזה מחויב בתשלום", זאת בניגוד לסטטוסים דומים כמו 403 (הגישה אסורה) שמונעים גישה כוללת. הוא מציין גם את גובה התשלום וכיצד ניתן לשלם.
הפרוטוקול הזה עדיין חדש יחסית ורוב החברות מגיעות להסכמים עם האתרים הגדולים כגון reddit, אבל אפשר בעיקרו של דבר להטמיע אותו בכל אתר שתרצו גם עבור גולש שרוצה לשלם על תוכן בעצמו.
אגב, Cloudflare כבר מקדמת מנגנון כזה בשם Pay Per Crawl שאמור לפשט עוד יותר את הדברים.
Machine Payment Protocol או MPP
מנגנון נוסף לתשלומים אוטומטיים בין תוכנות וסוכנים. הוא מיועד בין היתר לתשלומים קטנים ותכופים עבור שימוש במודלים, מידע וכלים. גם הוא פחות רלוונטי למסלול קנייה רגיל של מוצר פיזי.
לסיכום
אין ספק שבדיקת הקריאות של Cloudflare היא צעד בכיוון הנכון, במיוחד עבור מי שרוצה להיות מוכן ליישם שירותי Web מתקדמים ולוודא שסוכני AI יכולים לקרוא אותם.
אבל, וזה אבל חשוב: גם אם מקבלים ציונים נמוכים יחסית בחלק מהבדיקות, האתר עדיין יכול להיות קריא לחלוטין עבור מנועי AI.
העצה שלנו היא לבצע בכל מקרה את שלוש הבדיקות הראשונות, לראות מה המצב, וכיצד ניתן לשפר אותו. יחד עם זאת, הבדיקה הזו לחלוטין לא מחליפה אופטימיזציה למנועי AI ברמת התוכן מכיוון שזו פשוט לא המטרה שלה.